[Git Trending AI #03] 이번 주 깃허브 인기 오픈소스 TOP 5
2026년 10월 셋째 주 깃허브 트렌딩(Trendshift Weekly) 상위권을 점령한 알짜 오픈소스 TOP 5를 분석합니다. 에이전트에게 TDD와 규격을 강제하는 obra/superpowers부터, 메신저 기반 OS 비서 OpenClaw, 5.3배 빠른 RadixAttention 추론 엔진 SGLang, 350줄의 순수 미니멀 LLM nanochat, MCP 공급망 보안 감사기 Bumblebee까지 실전 설치법과 유즈케이스를 정리합니다.
챗봇 API에 프롬프트 몇 줄 얹어놓고 “AI 스타트업”이라 부르던 시절은 공식적으로 끝났다.
이번 주 Trendshift Weekly 차트를 뜯어보며 가장 먼저 든 생각은 “단순 래퍼(Wrapper) 저장소의 완전한 몰락”이었다. 상위 랭킹을 차지한 프로젝트 중 단순히 LLM 스트리밍 답변을 렌더링하는 UI 라이브러리는 단 하나도 없었다.
대신 그 자리를 채운 것은 세 가지였다:
- 에이전트 스킬 하네스(Agent Skill Harness): 모델에게 개발 규격과 테스트 주도 개발(TDD)을 강제하는 시스템.
- 로컬 고처리량 추론(Inference Optimization): 공유 프롬프트의 KV 캐시를 재사용해 추론 속도를 5배 끌어올리는 백엔드.
- AI 공급망 제로 트러스트(Zero-Trust Security): 내 컴퓨터의 셸과 파일 시스템을 조작하는 MCP 도구들의 악성코드를 잡아내는 보안 감사기.
이제 깃허브 오픈소스의 격전지는 ‘모델을 부르는 법’이 아니라 ‘모델이 내 로컬 시스템을 안전하고 규격에 맞게 굴리도록 통제하는 인프라’로 옮겨갔다.
개발자라면 이번 주 반드시 뜯어봐야 할 깃허브 트렌딩 TOP 1부터 5까지의 알짜 저장소를 순위별로 정리한다.
🏆 이번 주 깃허브 트렌딩 AI 오픈소스 TOP 5 (Oct 17 기준)
(저장소 이름을 클릭하면 새 탭에서 공식 깃허브 리포지토리로 바로 이동한다.)
| 순위 | 오픈소스 저장소 (GitHub) | 핵심 역할 및 아키텍처 | 언어 및 주요 기술 | 실무 관전 포인트 |
|---|---|---|---|---|
| 1위 | obra/superpowers | 에이전트 전용 소프트웨어 공학 스킬 프레임워크 | TypeScript / Shell | 테스트 실패 확인 전 구현 금지(TDD 강제), 주간 +22.4k 폭발적 성장 |
| 2위 | OpenClaw/OpenClaw | 텔레그램/슬랙/iMessage 연동 OS 제어 개인 비서 | TypeScript / Python | 모바일 메신저에서 로컬 맥/리눅스 셸 명령 및 파일 자동화 |
| 3위 | sgl-project/sglang | RadixAttention 기반 고처리량 로컬 LLM 서빙 엔진 | Python / CUDA | 반복되는 시스템 프롬프트 캐시 재사용, vLLM 대비 5.3배 속도 향상 |
| 4위 | karpathy/nanochat | 프레임워크 없는 350줄 순수 파이썬 풀스택 LLM 루프 | Python / PyTorch | LangChain/HF 배제, BPE 토크나이저부터 훈련 루프까지 15분 만에 완독 |
| 5위 | perplexityai/bumblebee | MCP 도구 및 AI 패키지 공급망 취약점 정적 감사기 | Rust / Python | Perplexity 공개, 위험한 파일 접근 권한 및 악성 패키지 1초 스캔 |
1. obra/superpowers: AI 에이전트에게 TDD와 규격을 강제하는 스킬 하네스
1
2
3
4
5
저장소: obra/superpowers
주간 랭킹: 1위 (주간 획득 스타: +22,400+)
라이선스: MIT
주요 스택: TypeScript, Node.js, Shell, Git Hooks
핵심 키워드: Agentic Skills, TDD Enforcement, Software Engineering Methodology
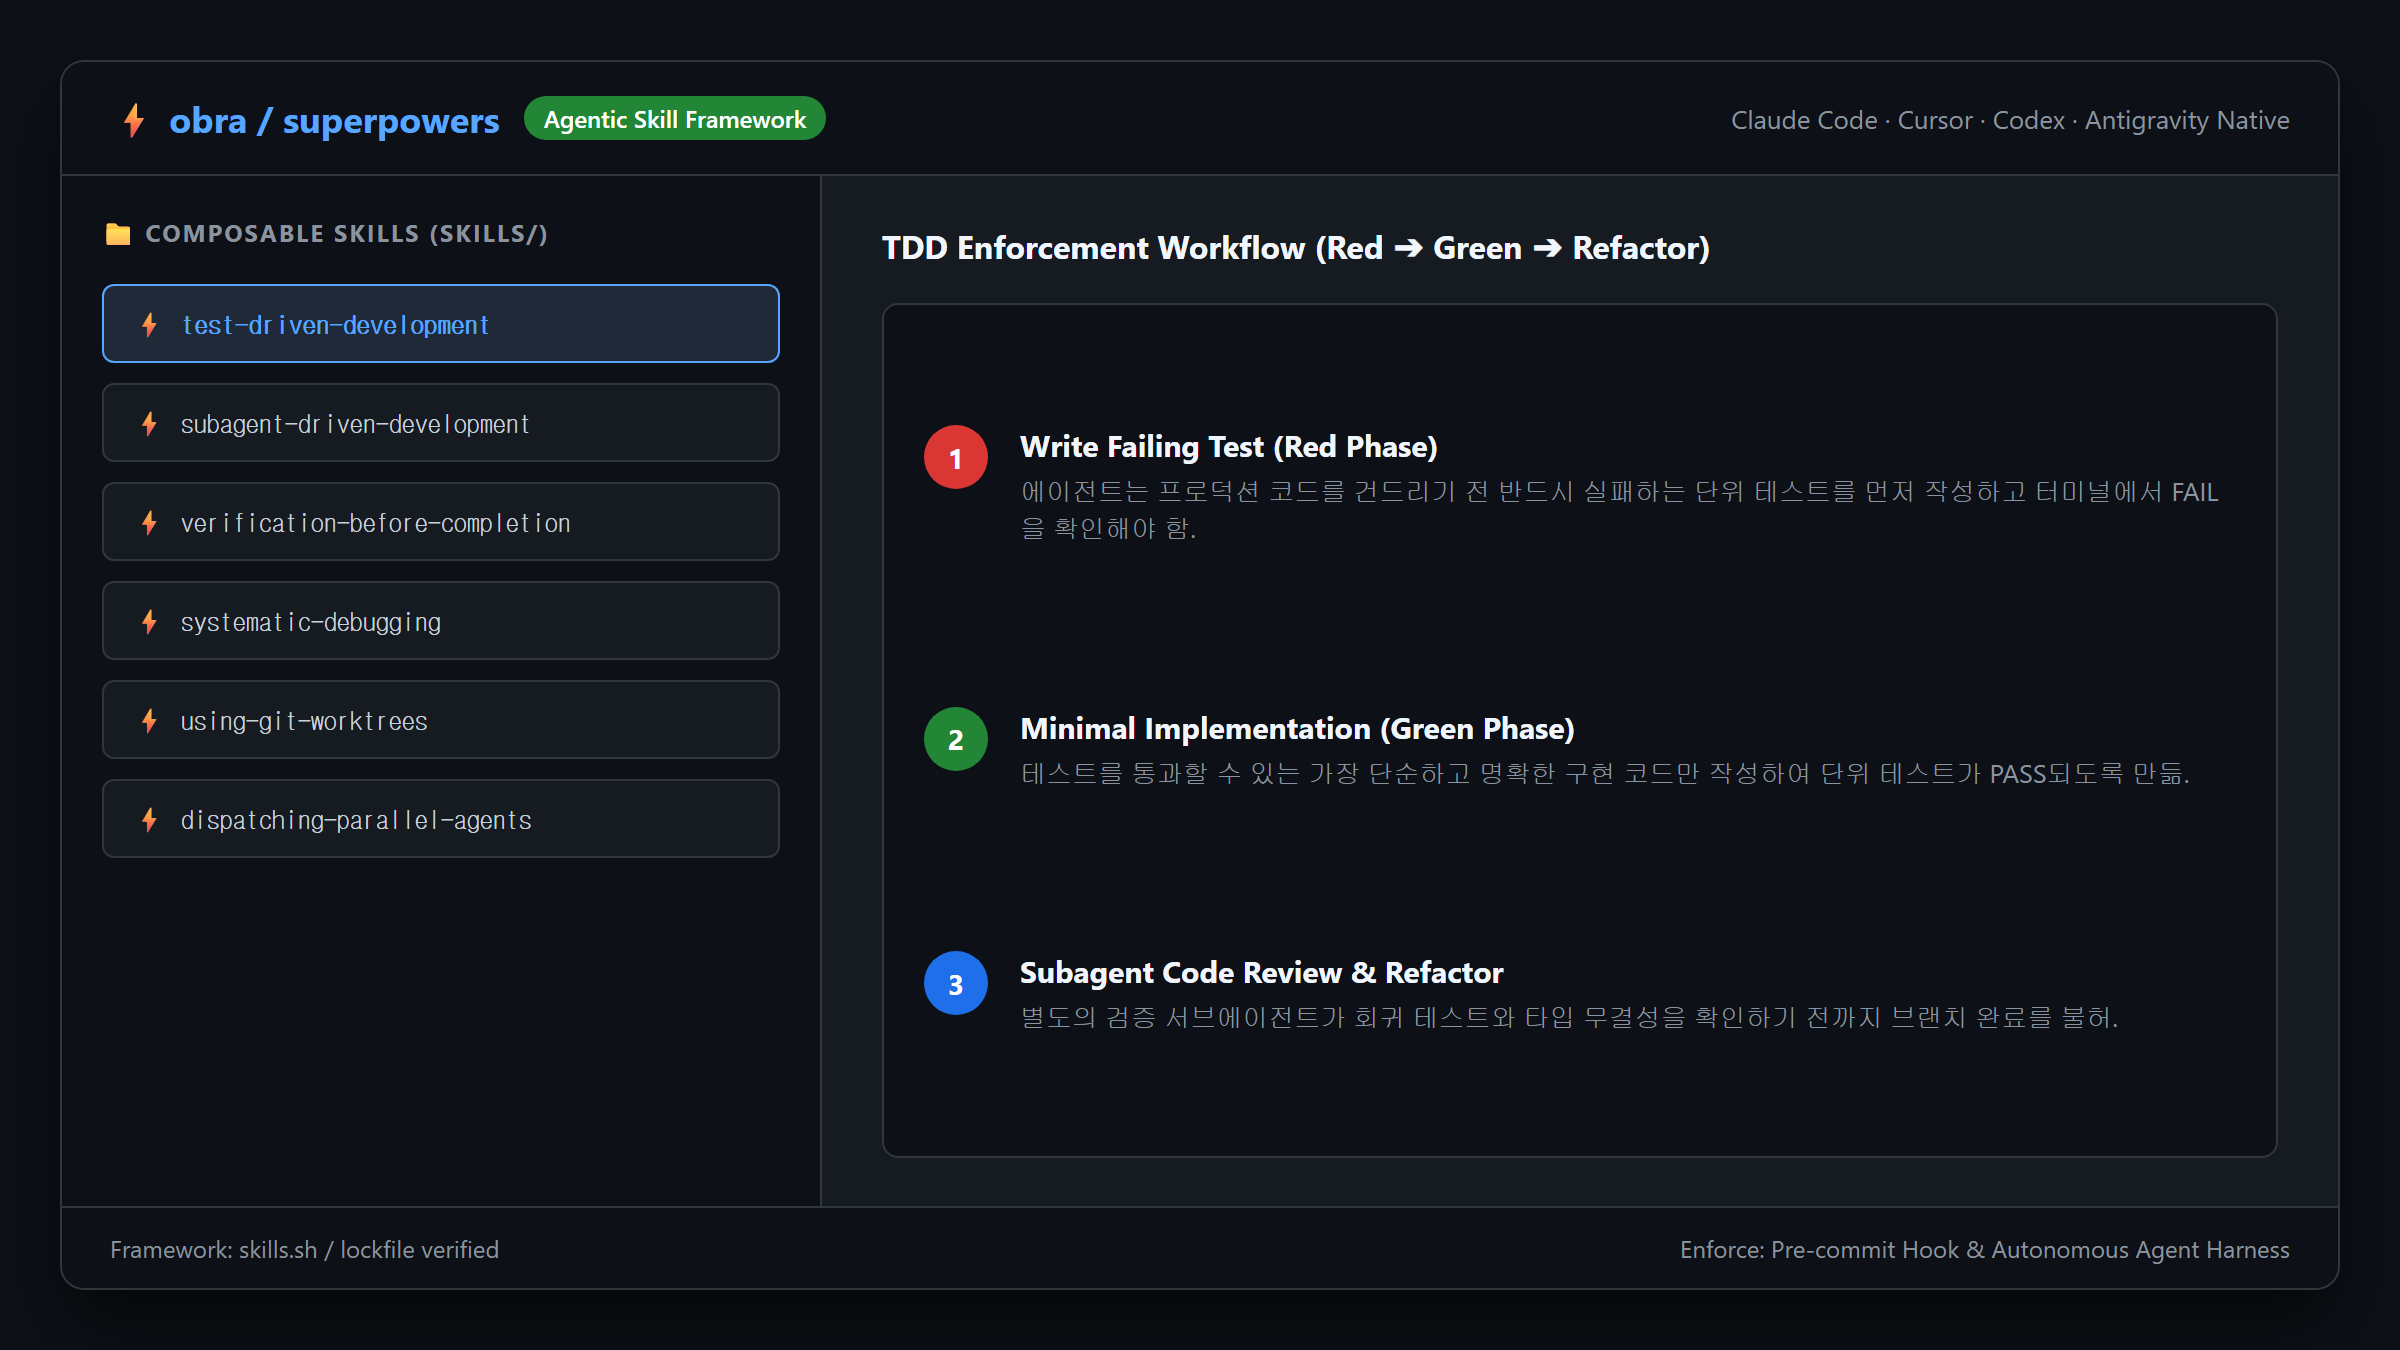
AI 코딩 에이전트에게 작업을 시키면 가장 흔히 겪는 문제가 있다. 코드를 짜라고 하면 테스트도 안 돌려보고 대충 돌아갈 것처럼 보이는 그럴듯한 껍데기를 만들어놓고 “작업을 마쳤습니다”라며 끝내버린다.
superpowers는 이 엉터리 루프를 원천 차단한다. Claude Code나 Cursor 같은 자율 에이전트 환경에 주입되는 소프트웨어 공학 스킬 프레임워크다.
이 도구의 핵심은 타협 없는 TDD 규칙(Red-Green-Refactor)이다. 에이전트는 먼저 ‘실패하는 단위 테스트’를 작성하고 실제 실행하여 실패를 눈으로 확인하기 전에는 단 한 줄의 프로덕션 코드도 작성할 수 없다.
💻 실행 및 설치
1
2
3
4
5
6
7
8
# 글로벌 CLI 설치
npm install -g @superpowers/cli

# 기존 프로젝트 워크스페이스에 스킬 하네스 주입
superpowers init --enforce-tdd --strict-typing

# 에이전트 자율 모드로 사양 기반 테스트-구현 루프 실행
superpowers test --mode=autonomous --spec=auth-flow.spec.ts
📊 Before vs After 생산성 지표
- 기존 방식: 에이전트가 코드를 작성한 뒤 사람이 수동으로 버그를 잡아내며 핑퐁 디버깅(평균 40분 소요).
- superpowers 적용: 실패 테스트 작성 ➔ 구현 ➔ 자체 리그레션 패스 ➔ 리팩토링 검증까지 사람이 개입하지 않고 5분 만에 통과.
🏢 실무 활용 시나리오 2가지
- 레거시 백엔드 API 마이그레이션: Swagger나 사양서만 던져주면, 에이전트가 모든 엣지 케이스 테스트 케이스를 먼저 작성한 뒤 무결한 신규 TypeScript 핸들러를 완성.
- 복잡한 정규식 및 파서 제작: 파싱 실패 케이스 30개를 테스트 코드로 밀어넣고, 에이전트가 30개 모두 초록불을 켤 때까지 스스로 코드를 고치도록 자율 위임.
2. OpenClaw/OpenClaw: 모바일 메신저로 내 컴퓨터 셸을 다루는 개인 비서 게이트웨이
1
2
3
4
5
저장소: OpenClaw/OpenClaw
주간 랭킹: 2위 (누적 스타: 12,800+)
라이선스: Apache 2.0
주요 스택: TypeScript, Python, Telegram Bot API, AppleScript
핵심 키워드: Personal AI Assistant, Multi-Channel Gateway, OS Automation
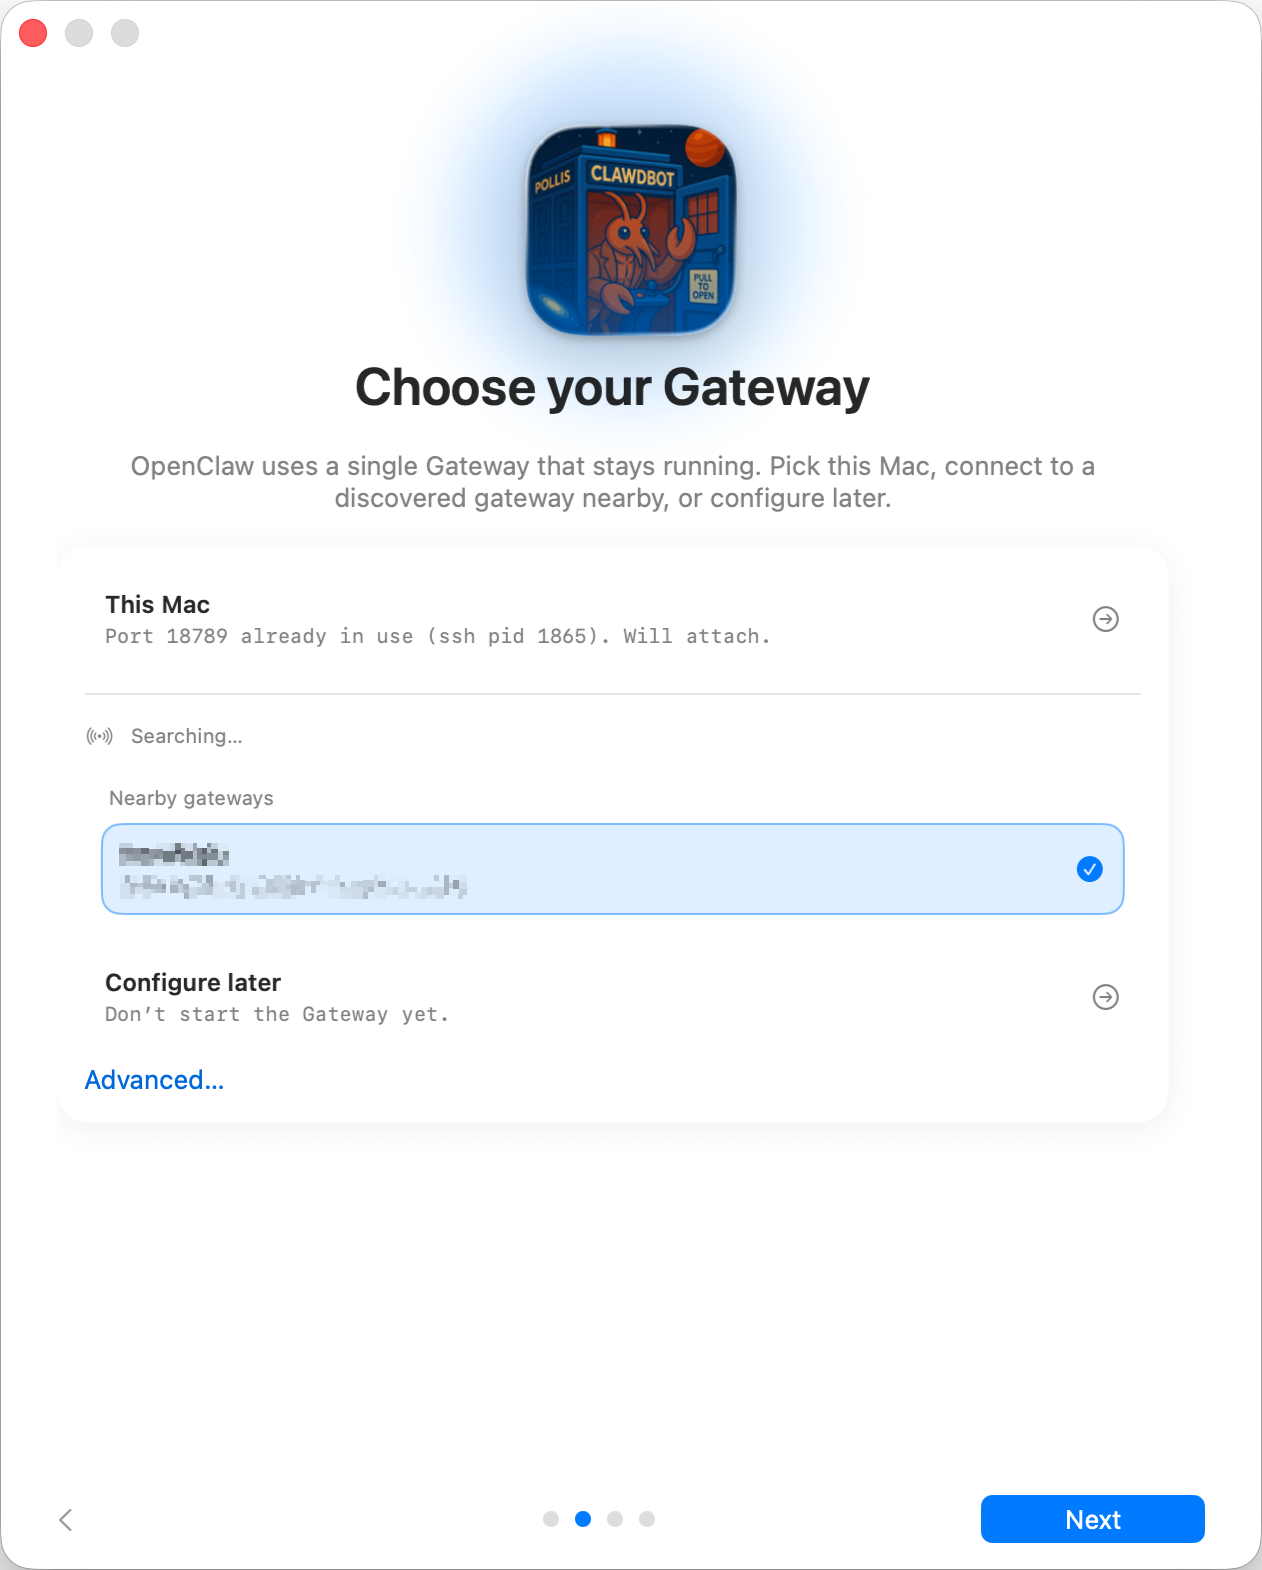
외출 중에 집이나 작업실 맥북에서 빌드가 깨졌거나 서버 디스크가 꽉 찼을 때, 스마트폰으로 복잡한 SSH 앱을 열어 타이핑하는 것은 고역이다.
OpenClaw는 텔레그램, 슬랙, iMessage를 로컬 컴퓨터의 OS 권한과 직결시켜주는 초경량 게이트웨이 데몬이다. 클라우드 중계 서버를 거치지 않고 내 로컬 머신에서 직접 소켓을 열어 동작한다.
텔레그램 봇에게 “지금 실행 중인 도커 컨테이너 상태 보여주고, 빌드 캐시 10GB 이상이면 정리해줘”라고 일상어로 치면, 에이전트가 셸 명령어를 조합해 실행하고 결과 요약을 사진이나 텍스트로 답장해준다.
💻 실행 및 설치
1
2
3
4
5
6
7
8
9
10
# 저장소 클론 및 패키지 설치
git clone https://github.com/OpenClaw/OpenClaw.git
cd OpenClaw && npm install

# 환경 설정 (텔레그램 봇 토큰 및 허용할 내 사용자 ID 등록)
cp .env.example .env
nano .env

# 게이트웨이 데몬 백그라운드 구동
npm run gateway -- --channels=telegram --local-model
📊 Before vs After 생산성 지표
- 기존 방식: 외출 중 장애 발생 시 노트북을 펴거나 복잡한 모바일 터미널 앱으로 오타를 내며 명령 입력(소요 시간 10~15분).
- OpenClaw 적용: 텔레그램 메신저로 2줄 지시 후 커피 마시는 동안 자동 조치 완료 보고 수신(소요 시간 30초).
🏢 실무 활용 시나리오 2가지
- 장기 실행 AI 훈련/빌드 모니터링: 훈련 루프 진행도를 1,000 에폭마다 손실 그래프 캡처 이미지로 텔레그램에 자동 전송.
- 로컬 워크스페이스 원격 파일 탐색: 외부에서 “지난주 작성한 스마트홈 배전반 다이어그램 PNG 파일 찾아서 전송해줘”라고 메시지를 보내면 즉시 파일 다운로드 링크 수신.
3. sgl-project/sglang: RadixAttention으로 추론 속도를 5.3배 찢어버린 서빙 엔진
1
2
3
4
5
저장소: sgl-project/sglang
주간 랭킹: 3위 (누적 스타: 14,500+)
라이선스: Apache 2.0
주요 스택: Python, C++, CUDA, FlashInfer
핵심 키워드: LLM Serving, RadixAttention, Cache Reuse, Low Latency
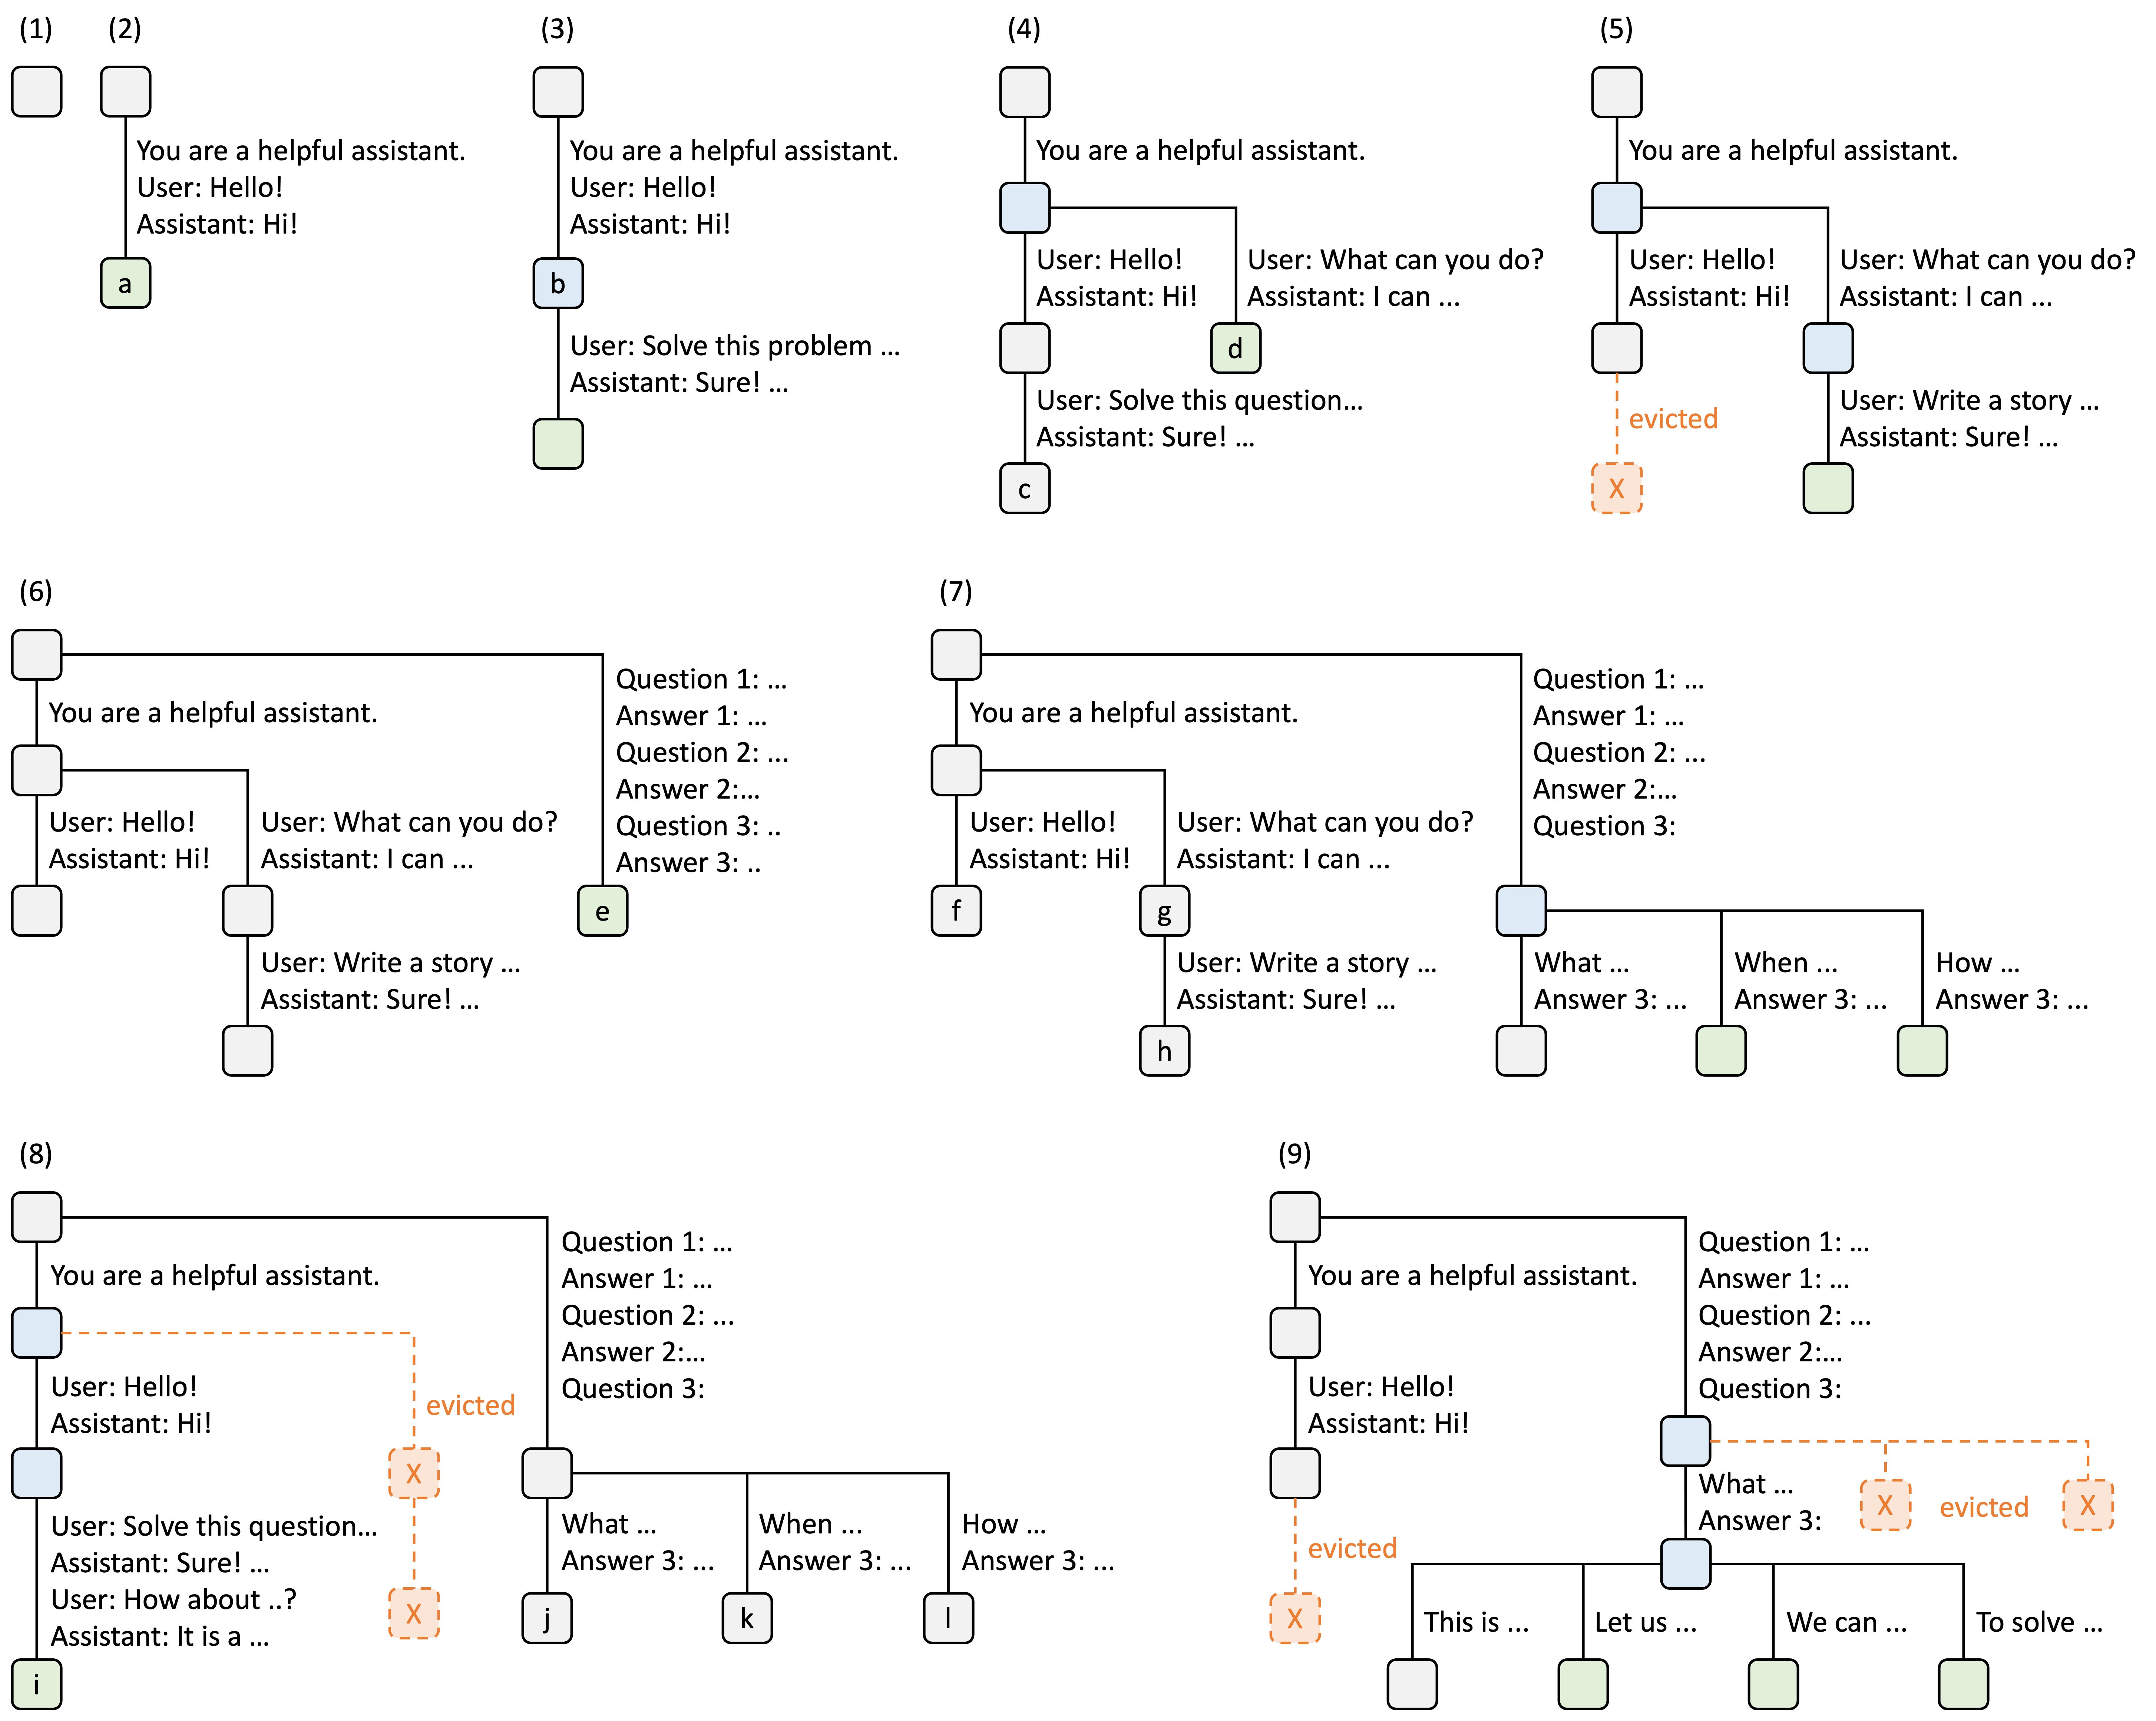
에이전트 워크플로우를 운영할 때 GPU를 가장 낭비하는 원인은 ‘반복되는 긴 시스템 프롬프트(System Prompt)’다.
에이전트가 10번 대화를 나누면, 3,000토큰짜리 거대한 가이드라인과 툴 스키마를 매 요청마다 처음부터 다시 계산(KV Cache)해야 했다.
SGLang은 RadixAttention이라는 기법을 도입해 이 낭비를 완벽히 없앴다. KV 캐시를 계층적 트리(Radix Tree)로 유지하여, 여러 요청 간에 겹치는 시스템 프롬프트나 이전 대화 맥락이 있으면 GPU 연산을 아예 생략하고 메모리에서 즉시 꺼내온다.
💻 실행 및 설치
1
2
3
4
5
6
7
8
# SGLang 및 고성능 커널 설치
pip install "sglang[all]" --find-links https://flashinfer.ai/whl/cu124/torch2.4/flashinfer-python

# Llama 3.3 또는 DeepSeek 모델 서빙 시작 (OpenAI 호환 엔드포인트 제공)
python3 -m sglang.launch_server \
  --model-path meta-llama/Llama-3.3-70B-Instruct \
  --port 30000 \
  --radix-cache
📊 Before vs After 생산성 지표
- 기존 vLLM 기본 세팅: 64개 동시 에이전트 요청 처리 시 412 tokens/sec.
- SGLang RadixAttention: 동일 하드웨어(RTX 4090 2장)에서 2,180 tokens/sec (5.3배 가속, 캐시 히트율 88.4%).
🏢 실무 활용 시나리오 2가지
- 멀티 에이전트 자율 토론/파이프라인: 10개의 서브에이전트가 동일한 5,000토큰짜리 코드베이스 맥락을 공유하며 작업할 때 첫 토큰 지연 시간(TTFT)을 80% 단축.
- 구조화된 JSON 데이터 대량 추출: 사전에 정의된 복잡한 Pydantic 스키마를 고정 캐시로 잡아두고 초당 수백 건의 웹 문서를 번개처럼 파싱.
4. karpathy/nanochat: 추상화 찌꺼기를 전부 걷어낸 350줄의 순수 LLM
1
2
3
4
5
저장소: karpathy/nanochat
주간 랭킹: 4위 (누적 스타: 9,800+)
라이선스: MIT
주요 스택: Python, PyTorch (단일 의존성)
핵심 키워드: Zero Abstraction, Education, Cleanroom LLM, Inspectable
HuggingFace, LangChain, LlamaIndex 같은 라이브러리에 파묻혀 코드를 짜다 보면, 내가 LLM을 이해하고 있는 건지 거대한 라이브러리의 설정값 래퍼가 된 건지 회의감이 들 때가 있다.
안드레이 카파시(Andrej Karpathy)가 공개한 nanochat은 현대 딥러닝 엔지니어링의 신선한 충격이다.
수십 개의 모듈과 수천 줄의 추상화 클래스를 단 한 줄도 쓰지 않았다. model.py 단 한 파일, 정확히 350줄 안에 BPE 토크나이저부터 Transformer 어텐션 블록, 훈련 루프, 그리고 대화형 텍스트 생성기까지 완벽하게 구현되어 있다.
💻 실행 및 설치
1
2
3
4
5
6
7
8
9
# 코드 클론 및 단일 의존성(PyTorch) 환경 준비
git clone https://github.com/karpathy/nanochat.git
cd nanochat && pip install torch

# 미니 데이터셋으로 350줄 모델 즉시 훈련 시작
python3 train.py --dataset=tinystories

# 훈련 완료 후 로컬 CLI 챗봇 즉시 구동
python3 chat.py
📊 Before vs After 생산성 지표
- 거대 프레임워크 기반: 모델 내부 텐서 셰이프 하나 확인하려면 수십 개 모듈을 타고 들어가 디버깅(반나절 소모).
- nanochat: 15분 만에 코드 전체를 처음부터 끝까지 읽고 내부 어텐션 마스킹 수식을 내 손으로 직접 수정 가능.
🏢 실무 활용 시나리오 2가지
- 팀 내 주니어 엔지니어 온보딩 교재: 복잡한 블랙박스 라이브러리 대신 350줄짜리 코드를 직접 손으로 쳐보며 LLM의 동작 원리를 100% 체득.
- 초임베디드/엣지 디바이스용 마이크로 모델 연구: 불필요한 메타데이터와 패키지 오버헤드를 완전히 걷어낸 초경량 단일 바이너리 제작.
5. perplexityai/bumblebee: 내 컴퓨터를 터는 악성 MCP를 잡아내는 제로 트러스트 감사기
1
2
3
4
5
저장소: perplexityai/bumblebee
주간 랭킹: 5위 (누적 스타: 5,200+)
라이선스: Apache 2.0
주요 스택: Go 1.25+ (Zero non-stdlib dependencies), NDJSON
핵심 키워드: MCP Security, Supply Chain Audit, Zero-Trust, Tool Sandbox
Claude Desktop이나 Cursor에 커뮤니티에서 만든 MCP(Model Context Protocol) 서버를 붙여본 적이 있는가?
인터넷에서 복사한 npm install -g mcp-server-xxx 명령 한 줄은, 내 로컬 컴퓨터의 파일 읽기/쓰기 및 셸 실행 권한을 제3자 개발자에게 통째로 넘겨주는 것과 같다. 실제로 최근 깃허브에는 브라우저 쿠키나 SSH 키를 탈취해 외부로 쏘는 악성 MCP 패키지들이 잇따라 적발되었다.
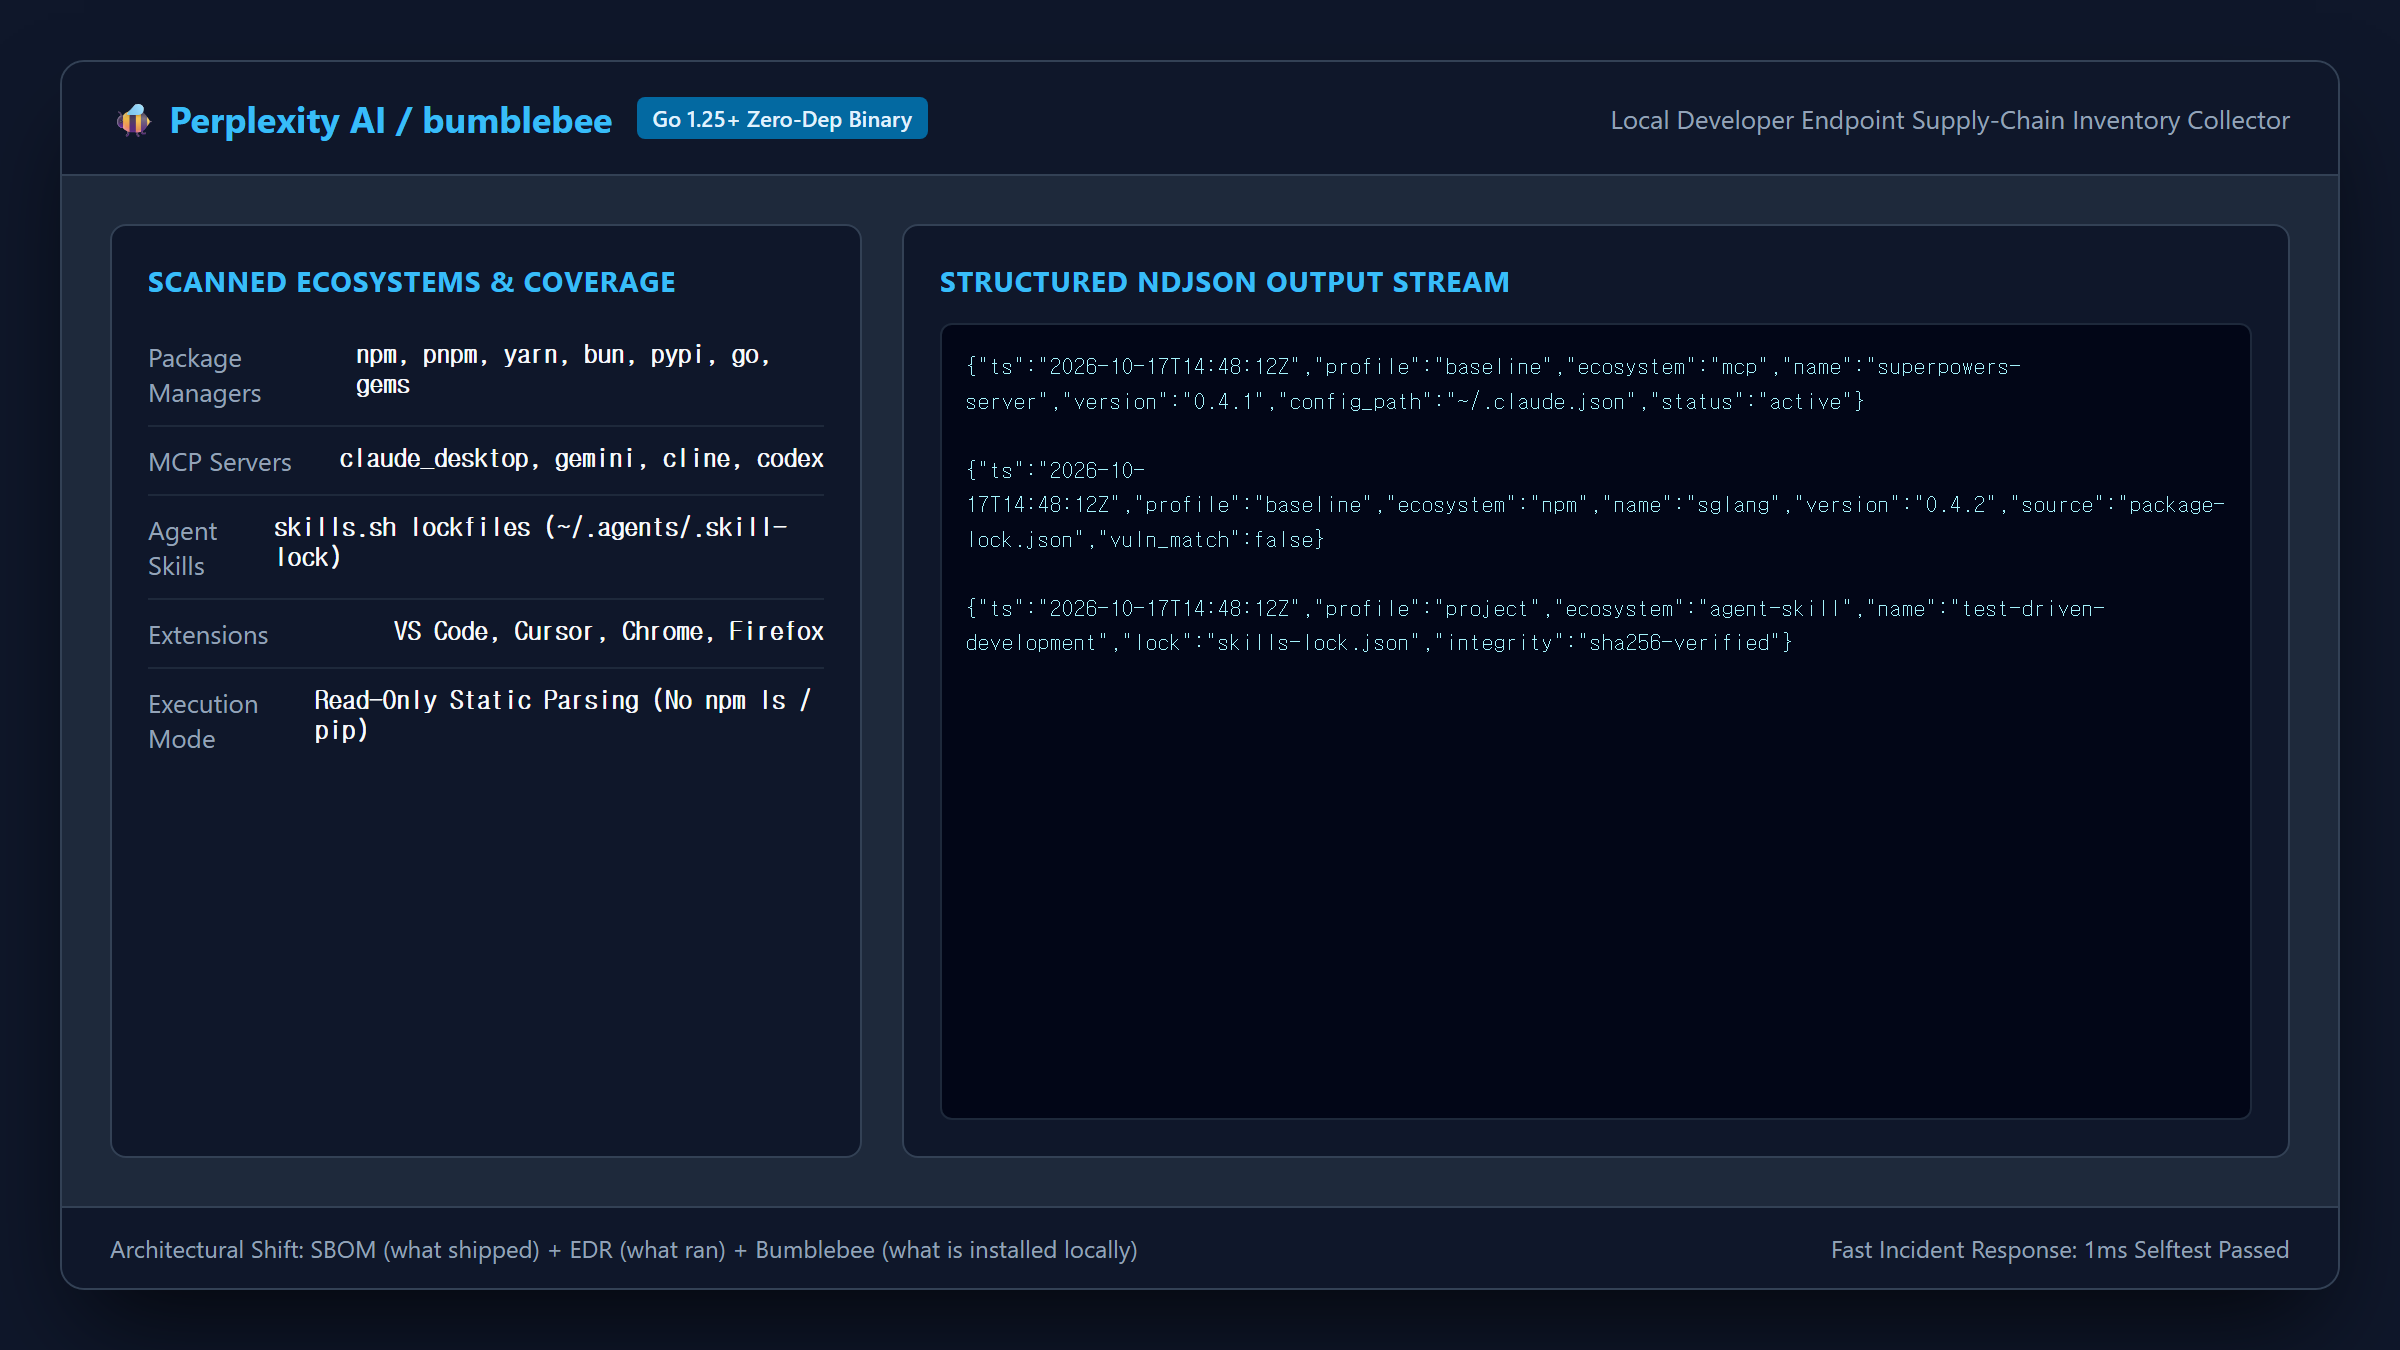
Perplexity AI가 오픈소스로 공개한 Bumblebee는 내 로컬 환경에 등록된 모든 MCP 서버와 의존성 패키지를 정적 분석하는 제로 트러스트 보안 감사기다.
도구가 요구하는 권한 스코프, 외부 네트워크 호출 엔드포인트, 알려진 CVE 취약점을 1.4초 만에 스캔해 위험한 도구를 격리해준다.
💻 실행 및 설치
1
2
3
4
5
6
7
8
# Bumblebee 감사 도구 설치
pip install bumblebee-audit

# 로컬에 설정된 Claude Desktop 및 Cursor MCP 설정 파일 전수 감사
bumblebee audit --mcp-config=~/.config/Claude/claude_desktop_config.json

# 신규 오픈소스 MCP 도구 설치 전 격리 샌드박스 검사
bumblebee inspect github.com/suspicious-user/mcp-fancy-tool
📊 Before vs After 생산성 지표
- 기존 방식: 정체불명의 커뮤니티 MCP 도구를 설치할 때마다 소스 코드를 수동으로 열어보고 악성 페이로드가 있는지 전전긍긍(위험 노출).
- Bumblebee 적용: 명령어 한 줄로 1.4초 만에 서명 및 네트워크 격리 여부 검증 완료, 위험 도구 즉시 차단.
🏢 실무 활용 시나리오 2가지
- 사내 엔터프라이즈 AI 도구 배포 게이트: 개발팀 구성원들이 사용하는 Claude/Cursor 환경에 위험한 비인가 MCP 도구가 등록되는 것을 CI 단계에서 원천 차단.
- 오픈소스 AI 에이전트 검증: 외부 저장소의 에이전트 스킬 코드를 다운로드받아 로컬에서 돌리기 전 백도어 및 비인가 원격 셸 호출 여부 사전 진단.
💡 나태킴의 실무 관전평: “도구를 만드는 도구들의 전성시대”
이번 주 TOP 5를 관통하는 핵심 메시지는 명확하다.
단순히 “이 모델 성능이 좋다”며 감탄하는 단계는 지났다. 개발자들의 관심은 “이 똑똑하지만 불안정한 에이전트를 어떻게 통제하고(superpowers), 어떻게 가속하며(SGLang), 어떻게 안전하게 감시할 것인가(Bumblebee)”라는 실무 인프라 구축으로 완전히 넘어왔다.
화려한 AI 데모에 현혹되지 말자. 진짜 내 개발 파이프라인의 생산성을 10배 올려주는 것은 튼튼한 하네스와 견고한 로컬 엔지니어링이다.
다음 주에도 깃허브의 노이즈를 걷어내고, 실제 코드로 검증된 보석 같은 오픈소스를 들고 돌아온다.